แกะคลิป: "Nothing is real anymore" · ทุกอย่างในคลิปปลอม แม้แต่คนพูด
@terencesia (บัญชียืนยันแล้ว) · ดึงผ่าน ScrapeCreators 31 ต.ค. 69 · แตกเฟรมดูทุก 0.5 วิ (45 เฟรม) · ป้าย เห็นในคลิป = ดูจากเฟรมจริง · ผมอนุมาน = เดาจากลักษณะงาน (เจ้าของคลิปไม่บอกเครื่องมือ ให้คอมเมนต์ "ai" เพื่อขอ workflow)
2.16Mยอดเล่น
41Kไลก์
22.6 วิความยาว
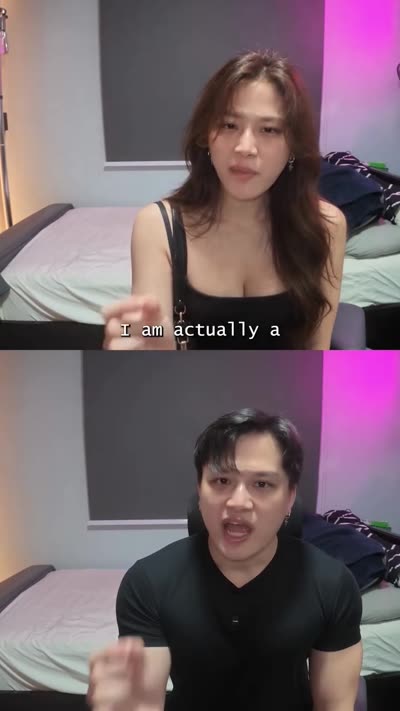
2 จอบน = ผล AI · ล่าง = ฟุตเทจจริง
อัปเดต: Terence Sia มีช่อง Telegram "The Workflow Lab" สอนวิธีนี้เอง · โพสต์ #317 #316 #314 #325 #327 = ถ่ายท่าทาง+เสียงตัวเองไปใส่ตัวละคร/ฉากใหม่ · #327 ระบุว่าใช้ Seedance 2.5 · #325 มี prompt character sheet · ยืนยันว่า workflow ขั้น 2–3 ด้านล่างตรงแนวที่เขาสอน (แต่ยังไม่รู้ตัวเปลี่ยนเสียงแน่ชัด) · เปิด PDF ได้ในแอป Telegram: t.me/TheWorkflowLab
เห็นอะไรในคลิป เห็นในคลิป
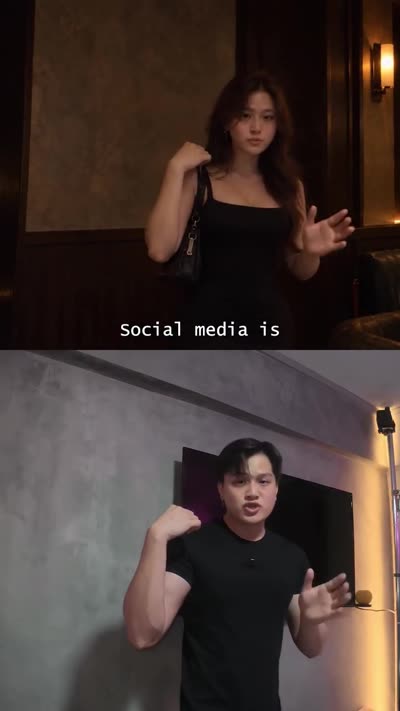
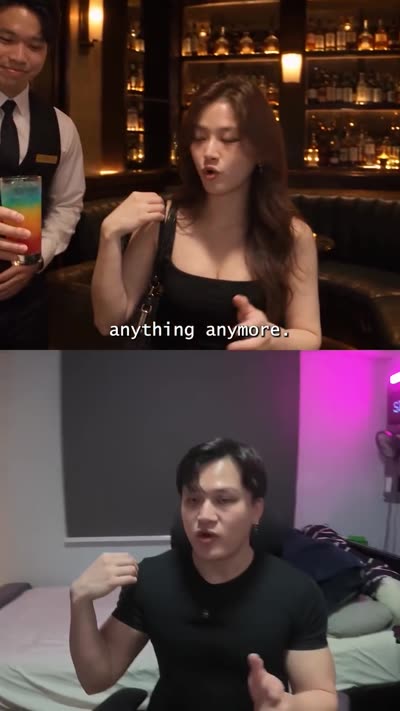
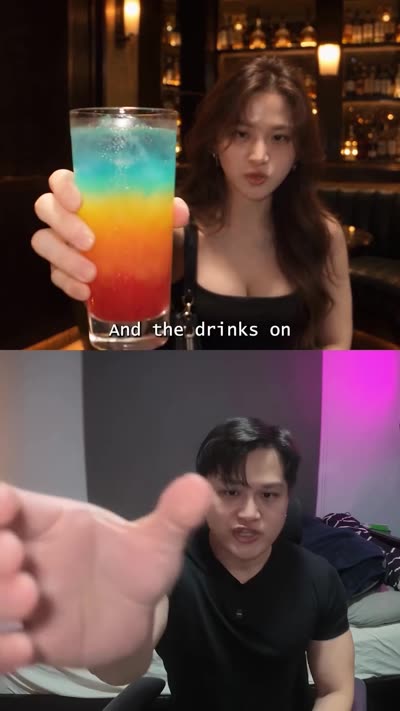
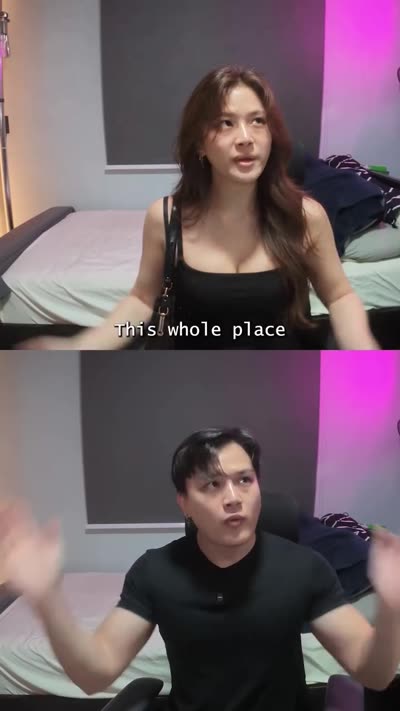
Framework: "เฉลยความปลอม 4 ชั้น"
- Hook ข้ออ้างใหญ่ (0–4 วิ): "โซเชียลน่ากลัว เชื่ออะไรไม่ได้แล้ว"
- เฉลยชั้น 1 คนข้าง ๆ (4–9 วิ): "บริกรคนนี้ปลอม"
- เฉลยชั้น 2 ของในมือ (9–13 วิ): "แก้วในมือก็ปลอม"
- เฉลยชั้น 3 ฉากทั้งหมด (13–16 วิ): "ที่นี่ปลอมทั้งหมด" + ฉากเปลี่ยนให้เห็นจริง
- เฉลยชั้น 4 ตัวคนพูด (16–20 วิ): "จริง ๆ ผมเป็นผู้ชาย" = จุดพีค
- CTA แชร์ + คอมเมนต์ "ai" เพื่อรับ workflow (= ล่ารายชื่อ DM)
ทำไมปัง: แต่ละชั้นแรงกว่าชั้นก่อน · จอล่างที่เป็นฟุตเทจจริงคือหลักฐาน คนดูต้องดูซ้ำเพื่อเทียบ · ตอนจบหักมุมจนคนอยากแชร์
Workflow สร้าง 6 ขั้น ผมอนุมาน
- ถ่ายตัวเองจริง 2 เทค (ห้องโถง + ห้องนอน) · ทำท่าเหมือนถือแก้ว ยื่นมือ หันไปทางคนข้าง ๆ ล่วงหน้าไว้ให้ AI เติมของ
- ทำภาพตัวละคร/เฟรมแรก: เอาเฟรมแรกของฟุตเทจไปแก้ด้วย AI ภาพ เป็นผู้หญิง + บาร์หรู + บริกร + แก้วสีรุ้ง
- ถ่ายท่าทางจากคลิปจริงไปใส่ตัวละคร (motion transfer / character swap): ใช้ฟุตเทจจริงเป็นตัวคุมท่า และภาพข้อ 2 เป็นหน้าตาตัวละคร · ช่วงห้องนอนสั่งเปลี่ยนแค่ตัวคน ไม่เปลี่ยนฉาก
- เปลี่ยนเสียงเป็นผู้หญิง: เสียงในคลิปอยู่ช่วงเสียงผู้หญิง (ค่ากลาง ~211 Hz ผมวัดแบบหยาบ) → น่าจะใช้ตัวเปลี่ยนเสียงแบบพูดเป็นพูด (speech-to-speech)
- ประกอบจอบน-ล่าง + ซับขาวตัวพิมพ์ดีด 2–3 คำต่อจังหวะ
- แคปชันชวนคอมเมนต์ "ai" → ระบบส่ง DM อัตโนมัติ
ใช้อะไร + ต้นทุนต่อคลิป ประมาณการ · ราคาอ้างอิงที่ค้นเมื่อ 31 ต.ค.
| ขั้น | เครื่องมือที่ทำได้ (เลือก 1) | ต้นทุนประมาณ |
|---|---|---|
| ภาพตัวละคร/เฟรมแรก | Nano Banana · gpt-image-2 · Higgsfield Soul | ~$0.04–0.2 ต่อภาพ × ลอง 3–5 ภาพ ≈ $1 |
| ถ่ายท่าทางไปใส่ตัวละคร (22.6 วิ) | Kling Motion Control (ใส่คลิปท่าทาง 3–30 วิ) · Higgsfield Genjutsu (Motion Transfer) · Wan Animate (open source รันเครื่องเอง) | Kling ~$0.084/วิ ≈ $2/รอบ · Genjutsu 98 เครดิต/14 วิ ที่ 720p (~$4.8) ≈ $8/รอบ · เผื่อเจนซ้ำ 3 รอบ ≈ $6–24 |
| เปลี่ยนเสียง | ElevenLabs Voice Changer (speech-to-speech) | รวมในแพ็กรายเดือน (Starter ~$5) |
| จอบน-ล่าง + ซับ | CapCut · ffmpeg (skill รอน) | ไม่มีค่าใช้จ่ายเพิ่ม |
| รวม | ~$10–30 ต่อคลิป (~350–1,100 บาท) · เวลาทำ ~2–4 ชม. (ส่วนใหญ่หมดไปกับรอเจน + เลือกเทค) |
รอนเอาไปใช้ยังไง
- เวอร์ชันรอน: รอนนั่งในห้องตัวเอง → จอบนเป็นรอนบนรูฟท็อปกรุงเทพ/เมืองในฝัน · เฉลยทีละชั้น: วิว → คนรอบตัว → ของในมือ → "ที่นี่คือห้องนอนผม"
- ตรงเป้า AI Creative ข้อ A (ถ่ายจริง + AI แปลงฉาก) และใช้หน้ารอนเองได้ ไม่ต้องสลับเป็นคนอื่น
- ใช้ CTA คอมเมนต์ "AI" ต่อกับระบบส่ง DM ที่รอนมีอยู่แล้ว → แจกบทเรียนตัวอย่างเป็น lead magnet ของคอร์ส
- เป็นบทเรียนในคอร์สได้ 1 บทเต็ม: "ถ่ายท่าให้ AI เติมของ" (ยื่นมือเปล่า แล้วให้ AI ใส่ของลงไป)
ข้อควรระวัง
- เครื่องมือในตาราง = ผมอนุมานจากลักษณะงาน เจ้าของคลิปไม่ได้บอก · ทางยืนยันคือคอมเมนต์ "ai" ขอ workflow จากเขา
- ต้นทุนเป็นค่าประมาณจากราคาที่ค้นได้ ยังไม่ได้ลองเจนจริง
- ทำเรื่อง "ปลอม" ต้องบอกคนดูว่าเป็น AI ในคลิป (แบบที่เขาทำ) เพื่อไม่ให้เป็นการหลอกลวง
ไฟล์: 05_LIBRARY/references/teardowns/REEL_DewJOweR9SI_terencesia.html · เฟรมจริง: img_DewJ/